AI Action Router - 경량 AI Agent 라우팅 모델
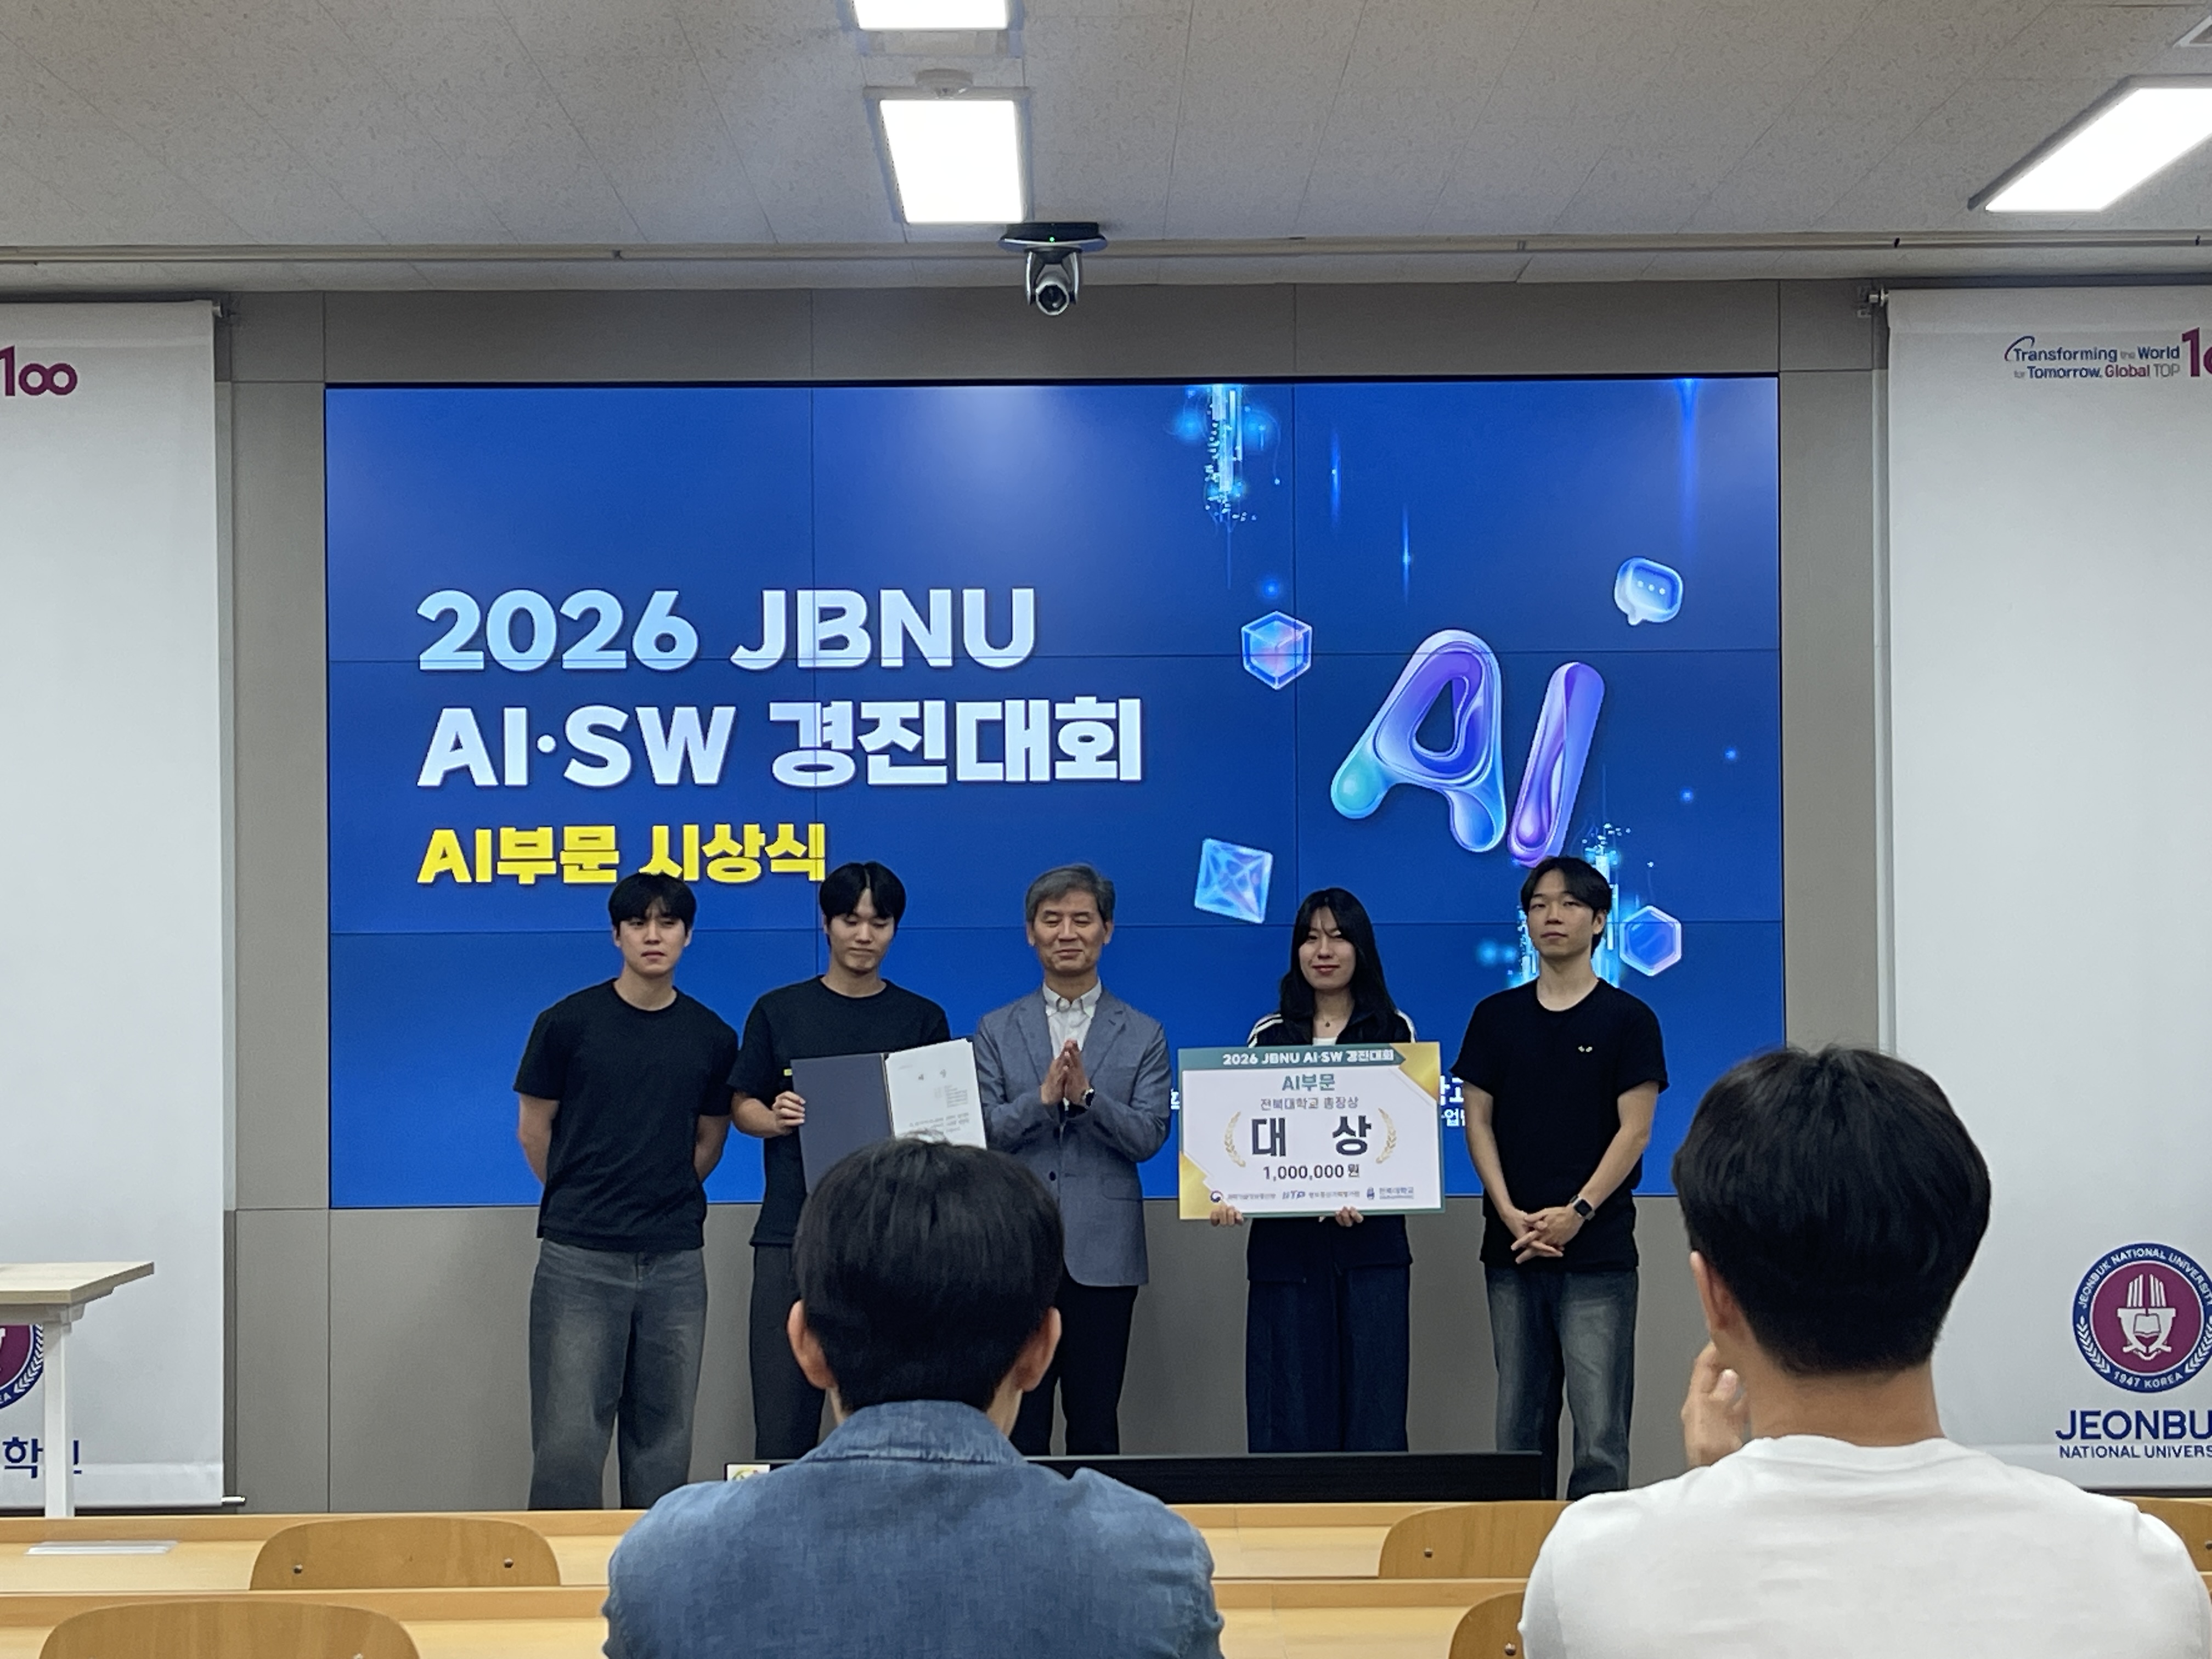
2026 JBNU AI·SW 경진대회 AI부문에서 자연어 상황과 사용자 요청을 읽고 AI Agent가 수행할 행동을 분류하는 경량 라우팅 모델을 개발했습니다.
평가 기준은 Macro F1 40점 + CPU 처리시간 30점 + GPU 처리시간 30점이었습니다. 따라서 단순히 가장 높은 F1을 만드는 것이 아니라 정확도와 추론 속도를 동시에 최적화해야 했습니다.
문제 접근
처음에는 30개 행동 클래스를 구분하는 일반적인 multiclass classification처럼 보였습니다.
하지만 데이터를 분석하면서, 각 입력에는 available_actions가 정확히 3개만 주어졌고, 정답은 항상 그 세 후보 안에 있다는 것을 알게 됐습니다.
따라서 문제를 30개의 모든 class 중 하나를 찾는 문제에서 30-class → 3-way, 즉 주어진 3개의 후보 안에서 가장 적합한 행동을 선택하는 문제로 재정의했습니다.
Candidate Masking
모델은 전체 30개 class에 대해 score를 계산하지만, 실제 선택 가능한 3개 후보를 제외한 27개 class의 logit을 -inf로 masking하는 Candidate Masking을 적용했습니다.
local validation 결과는 다음과 같습니다.
- candidate masking OFF: Macro F1 약 0.95787
- candidate masking ON: Macro F1 약 0.99722
이는 local validation 결과이며 hidden 평가 성능이 아닙니다.
더 복잡한 모델을 추가하기 전에 문제가 가진 구조적 제약을 먼저 활용해 보았습니다.
최신 모델이 항상 답은 아님
초기에는 다양한 모델을 직접 비교했습니다.
비교한 모델:
char_wbTF-IDF + Logistic Regression- LinearSVC
- SGD
- KoELECTRA
- RoBERTa
- Knowledge Distillation
- TF-IDF student model
local validation에서는 Transformer 계열도 높은 성능을 보였지만 hidden 평가에서는 그렇지 않았습니다.
대표 hidden Macro F1:
- char-TFIDF + LR: 0.80767
- RoBERTa: 0.78391
- distilled KoELECTRA: 0.58737
또한 Transformer 계열은 추론 속도와 model package size에서도 불리했습니다. 따라서 “최신 모델이므로 사용한다”가 아니라 실제 evaluation objective에서 성능·속도·안정성이 가장 좋은 모델을 선택했습니다.
한국어 Action Intent에 맞는 Character n-gram
30개 행동 클래스는 다음과 같은 실제 AI Agent의 action intent였습니다.
- academic search
- fact check
- email draft
- email send
- calendar create
- document summarize
- code debug
한국어 요청에서는 “요약”, “요약해”, “요약해줘”, “요약해 주세요”처럼 조사·어미·띄어쓰기 변화가 많았습니다.
따라서 word token보다 character n-gram이 이러한 표현 변형을 안정적으로 잡을 수 있다고 판단했습니다. 최종 분류 모델은 char_wb(3,4) TF-IDF + Logistic Regression을 사용했습니다.
클래스 편향 보정
개별 sample의 score만 독립적으로 보는 대신 batch 전체의 class distribution도 함께 고려했습니다.
특정 행동 class에 예측이 과도하게 몰리는 문제를 완화하기 위해 class별 score bias를 조정하는 Balanced Assignment를 적용했습니다.
이를 통해 hidden Macro F1이 0.80889 → 0.88347로 개선됐고, 이후 smoothing을 조정해 Hidden Macro F1 0.89225까지 개선했습니다.
0.0035 F1보다 속도를 선택
추가 성능 개선을 위해 2-model Ensemble도 테스트했습니다.
Ensemble은 hidden Macro F1을 0.89225에서 0.89580으로 소폭 높였지만, 모델 두 개를 추론하면서 GPU 처리시간이 증가해 최종 점수에서 이득이 상쇄됐습니다.
따라서 최종 제출에서는 F1이 조금 높은 ensemble 대신 전체 expected score가 더 높은 단일 경량 모델을 선택했습니다.
추론 파이프라인 자체를 최적화
성능이 일정 수준에 도달한 이후에는 모델 자체보다 inference pipeline을 최적화했습니다.
최종 구성:
- single
char_wb(3,4)TF-IDF + Logistic Regression - candidate masking
- balanced assignment
- unrolled / skiplog pure-Python inference
대회 환경과 내부 측정 기준에서 1,440개 sample 추론 약 0.27초를 기록했고, package 크기는 약 6.77MB였습니다. 추가 heavyweight inference dependency도 최소화했습니다.
실패한 실험
대회 과정에서 다음 접근도 검증했습니다.
- RoBERTa full model
- KoELECTRA
- Knowledge Distillation
- 한국어 synonym augmentation
- LinearSVC
- SGD
- TF-IDF feature 변경
- ensemble
- inference optimization
성능이 좋지 않은 실험도 제거하는 대신 왜 실패했는지를 기록하고 다음 실험의 판단 근거로 사용했습니다.
- 복잡한 Transformer → hidden generalization 및 speed에서 불리
- 데이터 augmentation → local 개선이 hidden 개선으로 이어지지 않음
- ensemble → F1 상승보다 inference cost 증가가 큼
이러한 trade-off를 확인한 뒤 복잡한 Transformer가 아닌 경량 선형 모델을 최종 모델로 선택했습니다.
최종 결과
- Final Score 95.30
- Hidden Macro F1 0.892
- 전체 1위
- 2026 JBNU AI·SW 경진대회 AI부문 대상 (전북대학교 총장상)
(Final Score는 Macro F1과 CPU·GPU 처리시간을 함께 반영한 대회 종합 점수이며 모델 정확도가 아닙니다.)
배운 점
데이터와 평가 구조를 먼저 분석해 30-class 문제를 후보 3개 선택 문제로 다시 정의하고, 다양한 모델과 후처리 방법을 비교했습니다. 또한 F1만 높이는 것이 아니라 CPU·GPU 처리시간까지 포함한 전체 evaluation objective를 기준으로 최종 모델을 선택했습니다.
이를 통해 문제 구조 분석 → 가설 설정 → 모델 비교 → 실패 원인 분석 → 평가 지표 최적화 → 최종 의사결정으로 이어지는 데이터 기반 문제 해결 과정을 경험했습니다.